Coupure de vmhba1 (prefered path) > Bascule sur vmhba2
Coupure de vmhba2 > Bascule sur vmhba32 (iSCSI)
Restauration de vmhba2 > Aucun effet
Restauration de vmhba1 > bascule sur vmhba1
Tout d’abord, vous remarquerez que ça bombarde à 10k+ IOPS (alors que le serveur Nexenta est une petite VM), remettez vous, c’est l’effet ZFS
Plus sérieusement, on remarque que le failover se fait dans le sens croissant des vmhba, ce qui règle le problème du choix d’iSCSI qu’en dernier recours étant donné que l’initiateur est toujours à 32 ou plus. De plus le failover se fait dans un délais raisonnable de 10 secondes (contre 30sec pour MPIO de Windows 2008 R2 et donc d’Hyper-V) mais cette solution pose un réel problème si le chemin préféré venait a être le seul à ne PAS être restauré car le chemin iSCSI est considéré comme les autres donc restera “valable” (cf FC to iSCSI failover : MRU ranking). Mais nous pensons que cela reste néanmoins une solution à connaitre et peut être à envisager pour les plus parano du HA.
Et le plus drôle dans l’histoire c’est que vous n’avez rien à configurer !
PS: Ça doit être possible à faire avec les autres hyperviseurs évidement…
On vous laissera juger du changement radical de mode de licencing (si vous avez des machines avec plus de 32/48Go par socket, ça va vous faire tout drôle…), joliment appelé “Pooled vRAM Entitlements” ainsi de la présence d’Auto Deploy dans l’offre alors que PXE Manager est à 1000 années lumières de ce truc (et ne cesse d’être amélioré par Max).
Pour finir, nous n’avons pas pu résister à la tentation de mettre l’eau à la bouche à ceux (dont nous faisons parti) qui râlent devant les tâches de “Maintenance Mode” interminables sur les serveurs n’ayant que des vmnic en GbE :
Nous profitons de l’annonce du lancement de la version Community Edition de VMTurbo (anciennement VMTurbo Monitor mais pas de gros changements, juste un renommage marketing) pour vous faire partager notre expérience très positive du produit.
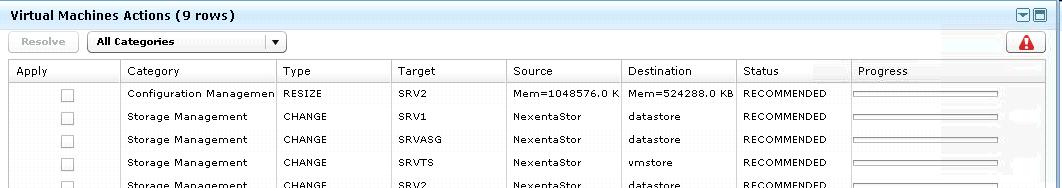
A la base, hors considérations de licensing, VMTurbo Virtualization Management Suite est (surprise !) une suite de composants offrant (re-surprise !) un outil de monitoring (c’est ce composant qui est gratuit) sur lequel s’appuient 3 autres outils : capacity planning, reporting et optimisation. Ce dernier est un genre de DRS à large scope qui peut vous suggérer (et surtout le faire pour vous si vous achetez la licence) de diminuer la quantité de ram d’une VM, de lui rajouter un vcpu ou de la déplacer sur un autre datastore en fonction des métrics remonté par monitor.
Le composant qui nous intéresse le plus est évidement ”monitor” qui se démarque par sa simplicité et surtout par sa fluidité (accès web mais flash). Même sur une grosse infra vous n’aurez pas l’effet “usine à gaz” que peuvent offrir certains produits concurrents…
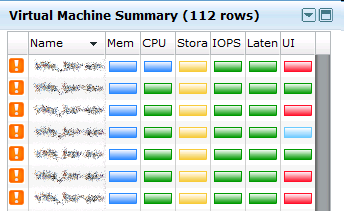
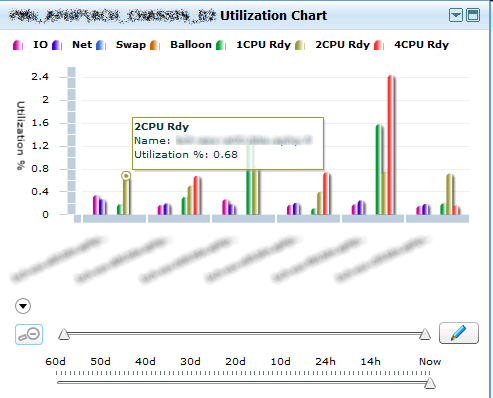
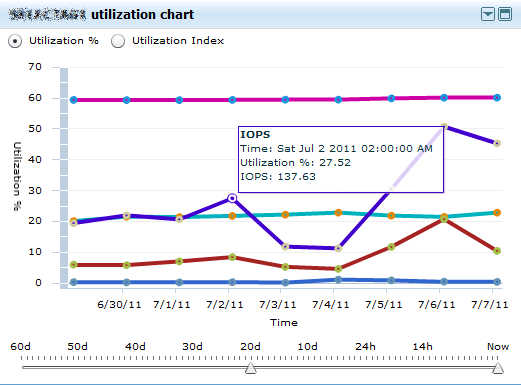
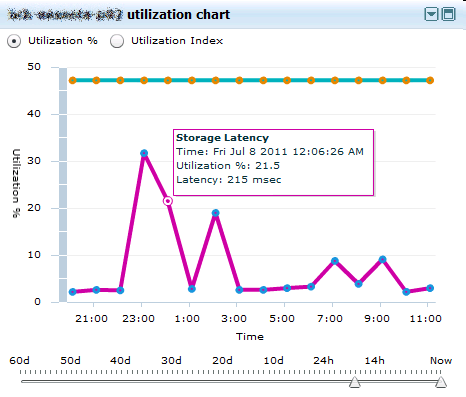
Cette simplicité peut aussi lui être reproché mais imaginons que vous souhaitiez vérifier que vous n’avez pas trop de CPU Ready Time sur toutes les VM d’un cluster, que vous souhaitiez connaitre la tendance en IOPS d’une VM, ou encore que vous vous inquiétiez du niveau de latence d’un datastore, ça vous donne quelque chose comme ça :
Ajoutez à cela un format appliance (assez light) en ovf avec pour seule configuration la config réseau et l’ajout du (ou des) vcenter à monitorer et vous obtenez un produit à tester d’urgence si ce n’est pas déjà fait !
La nomination des vExpert 2011 est tombé ce matin et a littéralement enflammé Twitter.
Comme quelques français privilégiés (une liste complète sera bientôt dispo chez VMware, mais vous pouvez toujours consulter celle d’Arnim), notre titre a été reconduit cette année et pour cela je vous remercie à nouveau pour votre soutien, vos commentaires et je me réjouis de constater que l’enthousiasme qui nous anime tous ne faibli pas d’un yota !
Parce qu’une bonne infra a besoin d’un bon stockage, nous inaugurons une nouvelle section “ZFS” dans laquelle nous tenterons de regrouper des liens précieux à ce sujet. L’idéal étant néanmoins de commencer par l’article Wikipédia dont la phrase suivante résume l’un des intérêts majeurs de ZFS :
One major feature that distinguishes ZFS from other file systems is that ZFS is designed from the ground up with a focus on data integrity
The original promise of RAID (Redundant Arrays of Inexpensive Disks) was that it would provide fast, reliable storage using cheap disks. The key point was cheap; yet somehow we ended up here.
A planned PDL occurs when there is an intent to remove a device presented to the ESXi host. The datastore must first be unmounted, then the device detached before the storage device can be unpresented at the storage array.

 Nous vous conseillons fortement de commencer par la partie What’s New Whitepapers qui synthétise l’ensemble

 Loading ...