[PSH] Les alarmes de datastore qui manquent à vCenter (par cluster)
Posted by NiTRo | Filed under Hardware, Performance, VMware
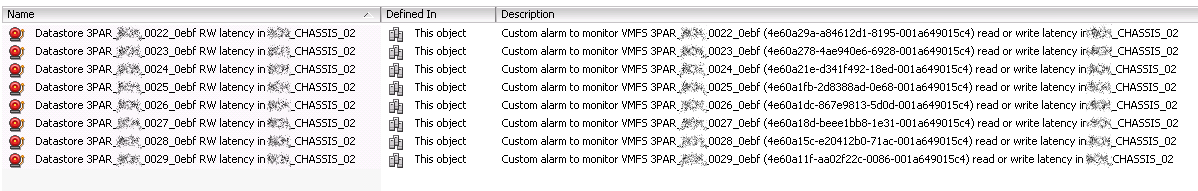
Suite à notre post sur la création d’alarmes de latence pour les datastore, nous nous sommes aperçu que sur des environnements relativement important cela pouvait générer une quantité importante d’events inutiles. En effet, les alarmes étant créées à la “racine” du vCenter et propagées sur tous les hosts par héritage, il est fréquent de voir des events liés à une alarme (green>gray et gray>green lors d’un reboot par exemple) d’un datastore n’existant pas sur l’ESX en question. Nous avons donc modifiés nos onliner pour que les alarmes soient créées à la “racine” des cluster et comme le nom d’une alarme doit être unique, nous y avons rajouté le nom du cluster :
Alarme de latence Read ou Write pour datastore partagé NFS par cluster, yellow 300ms/5min et red 500ms/3min (mailto:admin@vmware.local) :
foreach ($vicluster in Get-View -ViewType ClusterComputeResource) {foreach ($dsname in ($vicluster.Datastore|%{Get-View $_}|?{$_.summary.Accessible -and $_.summary.MultipleHostAccess -and $_.info.nas})){if (!((Get-View AlarmManager).GetAlarm($vicluster.moref)|?{(get-view $_).info.name -match "Datastore $($dsname.name) datastore RW latency"})){(Get-View AlarmManager).CreateAlarm($vicluster.moref,(New-Object VMware.Vim.AlarmSpec -Property @{Name = "Datastore $($dsname.name) datastore RW latency in $($vicluster.name)";Description = "Custom alarm to monitor NFS $($dsname.name) ($($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)) read or write latency in $($vicluster.name)";Enabled = $true;expression = (New-Object VMware.Vim.OrAlarmExpression -Property @{expression = @((New-Object VMware.Vim.MetricAlarmExpression -Property @{Metric = (New-Object VMware.Vim.PerfMetricId -Property @{CounterId = ((Get-View (Get-View ServiceINstance).Content.PerfManager).PerfCounter|?{$_.groupinfo.key -match "datastore"}|?{$_.nameinfo.key -match "totalReadLatency"}|?{$_.RollupType -match "average"}).key;Instance = ($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)});Operator = "isAbove";Yellow = "300";YellowInterval = "300";Red = "500";RedInterval = "180";Type = "HostSystem"});(New-Object VMware.Vim.MetricAlarmExpression -Property @{Metric = (New-Object VMware.Vim.PerfMetricId -Property @{CounterId = ((Get-View (Get-View ServiceINstance).Content.PerfManager).PerfCounter|?{$_.groupinfo.key -match "datastore"}|?{$_.nameinfo.key -match "totalWriteLatency"}|?{$_.RollupType -match "average"}).key;Instance = ($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)});Operator = "isAbove";Yellow = "300";YellowInterval = "300";Red = "500";RedInterval = "180";Type = "HostSystem"}))});Action=(New-Object VMware.Vim.GroupAlarmAction -Property @{Action= (New-Object VMware.Vim.AlarmTriggeringAction -Property @{Action = (New-Object VMware.Vim.SendEmailAction -Property @{ToList = "admin@vmware.local";Subject = "[vAlarm] $($dsname.name) RW latency on {targetName}";CcList = "";Body = ""});TransitionSpecs = @((New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "green";FinalState = "yellow";Repeats = $false});(New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "yellow";FinalState = "red";Repeats = $false}))})});ActionFrequency = "1800"}))}}}
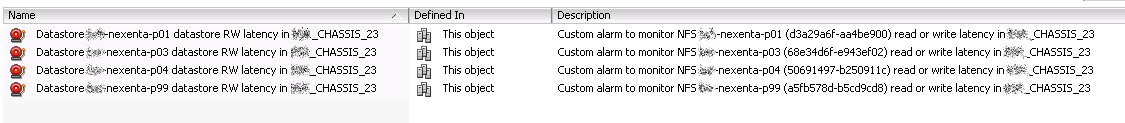
Alarme de latence Read ou Write pour datastore partagé VMFS par cluster, yellow 30ms/5min et red 40ms/3min (mailto:admin@vmware.local) :
foreach ($vicluster in Get-View -ViewType ClusterComputeResource) {foreach ($dsname in ($vicluster.Datastore|%{Get-View $_}|?{$_.summary.Accessible -and $_.summary.MultipleHostAccess -and $_.info.vmfs})){if (!((Get-View AlarmManager).GetAlarm($vicluster.moref)|?{(get-view $_).info.name -match "Datastore $($dsname.name) RW latency in $($vicluster.name)"})){(Get-View AlarmManager).CreateAlarm($vicluster.moref,(New-Object VMware.Vim.AlarmSpec -Property @{Name = "Datastore $($dsname.name) RW latency in $($vicluster.name)";Description = "Custom alarm to monitor VMFS $($dsname.name) ($($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)) read or write latency in $($vicluster.name)";Enabled = $true;expression = (New-Object VMware.Vim.OrAlarmExpression -Property @{expression = @((New-Object VMware.Vim.MetricAlarmExpression -Property @{Metric = (New-Object VMware.Vim.PerfMetricId -Property @{CounterId = ((Get-View (Get-View ServiceINstance).Content.PerfManager).PerfCounter|?{$_.groupinfo.key -match "datastore"}|?{$_.nameinfo.key -match "totalReadLatency"}|?{$_.RollupType -match "average"}).key;Instance = ($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)});Operator = "isAbove";Yellow = "30";YellowInterval = "300";Red = "40";RedInterval = "180";Type = "HostSystem"});(New-Object VMware.Vim.MetricAlarmExpression -Property @{Metric = (New-Object VMware.Vim.PerfMetricId -Property @{CounterId = ((Get-View (Get-View ServiceINstance).Content.PerfManager).PerfCounter|?{$_.groupinfo.key -match "datastore"}|?{$_.nameinfo.key -match "totalWriteLatency"}|?{$_.RollupType -match "average"}).key;Instance = ($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)});Operator = "isAbove";Yellow = "30";YellowInterval = "300";Red = "40";RedInterval = "180";Type = "HostSystem"}))});Action=(New-Object VMware.Vim.GroupAlarmAction -Property @{Action= (New-Object VMware.Vim.AlarmTriggeringAction -Property @{Action = (New-Object VMware.Vim.SendEmailAction -Property @{ToList = "admin@vmware.local";Subject = "[vAlarm] $($dsname.name) RW latency on {targetName}";CcList = "";Body = ""});TransitionSpecs = @((New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "green";FinalState = "yellow";Repeats = $false});(New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "yellow";FinalState = "red";Repeats = $false}))})});ActionFrequency = "1800"}))}}}
Alarme de latence SIOC Normalized Latency pour datastore partagé par cluster, yellow 30ms/5min et red 40ms/3min (mailto:admin@vmware.local) :
foreach ($vicluster in Get-View -ViewType ClusterComputeResource) {foreach ($dsname in ($vicluster.Datastore|%{Get-View $_}|?{$_.summary.Accessible -and $_.summary.MultipleHostAccess -and $_.IormConfiguration.Enabled})){if (!((Get-View AlarmManager).GetAlarm($vicluster.moref)|?{(get-view $_).info.name -match "Datastore $($dsname.name) SIOC Normalized Latency in $($vicluster.name)"})){(Get-View AlarmManager).CreateAlarm($vicluster.moref,(New-Object VMware.Vim.AlarmSpec -Property @{Name = "Datastore $($dsname.name) SIOC Normalized Latency in $($vicluster.name)";Description = "Custom alarm to monitor $($dsname.name) ($($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)) datastore SIOC Normalized Latency in $($vicluster.name)";Enabled = $true;expression = (New-Object VMware.Vim.OrAlarmExpression -Property @{expression = @((New-Object VMware.Vim.MetricAlarmExpression -Property @{Metric = (New-Object VMware.Vim.PerfMetricId -Property @{CounterId = ((Get-View (Get-View ServiceINstance).Content.PerfManager).PerfCounter|?{$_.groupinfo.key -match "datastore"}|?{$_.nameinfo.key -match "sizeNormalizedDatastoreLatency"}|?{$_.RollupType -match "average"}).key;Instance = ($dsname|%{$_.Host}|%{$_.MountInfo.Path.split("/")[-1]}|sort -unique)});Operator = "isAbove";Yellow = "30000";YellowInterval = "300";Red = "40000";RedInterval = "180";Type = "HostSystem"}))});Action=(New-Object VMware.Vim.GroupAlarmAction -Property @{Action= (New-Object VMware.Vim.AlarmTriggeringAction -Property @{Action = (New-Object VMware.Vim.SendEmailAction -Property @{ToList = "admin@vmware.local";Subject = "[vAlarm] $($dsname.name) SIOC Normalized Latency on {targetName}";CcList = "";Body = ""});TransitionSpecs = @((New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "green";FinalState = "yellow";Repeats = $false});(New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "yellow";FinalState = "red";Repeats = $false}))})});ActionFrequency = "1800"}))}}}
Alarme de Disk Command aborts pour datastore VMFS partagé par cluster, en cas de défaillance/saturation DAS/SAN/iSCSI (mailto:admin@vmware.local) :
foreach ($vicluster in Get-View -ViewType ClusterComputeResource) {foreach ($diskname in ($vicluster.Datastore|%{Get-View $_}|?{$_.info.vmfs -and $_.summary.Accessible -and $_.summary.MultipleHostAccess}|%{$_.info.vmfs.extent}|%{$_.diskname})){if (!((Get-View AlarmManager).GetAlarm($vicluster.moref)|?{(get-view $_).info.name -match "Disk $diskname command aborts"})){(Get-View AlarmManager).CreateAlarm($vicluster.moref,(New-Object VMware.Vim.AlarmSpec -Property @{Name = "Disk $diskname command aborts in $($vicluster.name)";Description = "Custom alarm to monitor $diskname disk command aborts in $($vicluster.name)";Enabled = $true;expression = (New-Object VMware.Vim.OrAlarmExpression -Property @{expression = (New-Object VMware.Vim.MetricAlarmExpression -Property @{Metric = (New-Object VMware.Vim.PerfMetricId -Property @{CounterId = ((Get-View (Get-View ServiceINstance).Content.PerfManager).PerfCounter|?{$_.groupinfo.key -match "disk"}|?{$_.nameinfo.key -match "commandsAborted"}|?{$_.GroupInfo.Key -ne "virtualDisk"}|?{$_.RollupType -match "summation"}).key;Instance = $diskname});Operator = "isAbove";Yellow = "1";Red = "2";Type = "HostSystem"})});Action=(New-Object VMware.Vim.GroupAlarmAction -Property @{Action= (New-Object VMware.Vim.AlarmTriggeringAction -Property @{Action = (New-Object VMware.Vim.SendEmailAction -Property @{ToList = "admin@vmware.local";Subject = "[vAlarm] command aborts on disk $diskname on {targetName}";CcList = "";Body = ""});TransitionSpecs = @((New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "green";FinalState = "yellow";Repeats = $false});(New-Object VMware.Vim.AlarmTriggeringActionTransitionSpec -Property @{StartState = "yellow";FinalState = "red";Repeats = $true}))})});ActionFrequency = "1800"}))}}}
Tags: monitoring, NFS, PowerCLI, powershell, SAN, SIOC, vCenter, VMFS

 )
 Loading ...