Pimp My (SATA) Ports

Alors que nous pensions avoir fait le tour des possibilités du HP N40L N54L ProLiant MicroServer, nous somme tombé par hasard sur un post revisitant le fameux mod de BIOS, permettant d’avoir accès à tout un tas de hidden settings, afin de pouvoir utiliser un port multiplier sur le eSATA.

A Serial ATA port multiplier is a device that allows multiple SATA devices to be connected to a single SATA host port.

Un peu comme un SAS expander mais en un peu moins enterprise class… Au passage, c’est ce qu’utilise Backblaze pour faire tenir 180 To dans un server 4U.

L’idée de pouvoir se passer de la carte contrôleur qui monopolise le seul port pcie (potable) de notre N40L nous séduit. 40€-et-quelques-sur-ebay plus tard (carte et cables courts compris), FreeNAS reconnait parfaitement le bidule grâce aux modifications de BIOS :

pmp0 at ahcich5 bus 0 scbus7 target 15 lun 0
pmp0: ATA-0 device
pmp0: 300.000MB/s transfers (SATA 2.x, NONE, PIO 8192bytes)
pmp0: 5 fan-out ports

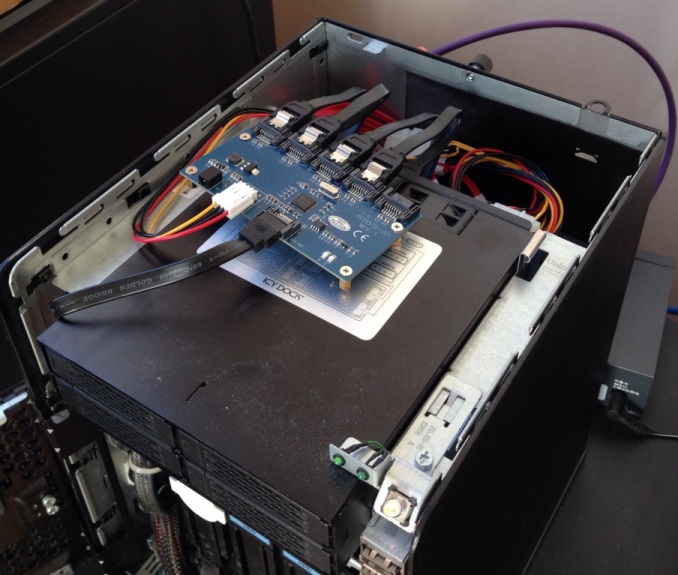
La carte que nous avons trouvé étant limité à 5 ports, nous avons été contraint d’utiliser un rack 4x 2.5″ mais le pcb se loge parfaitement entre ce dernier et la partie supérieure du boitier :
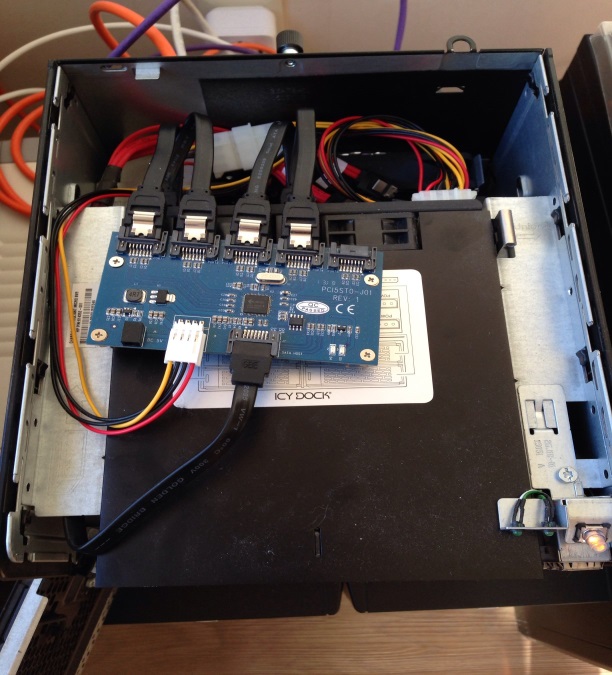
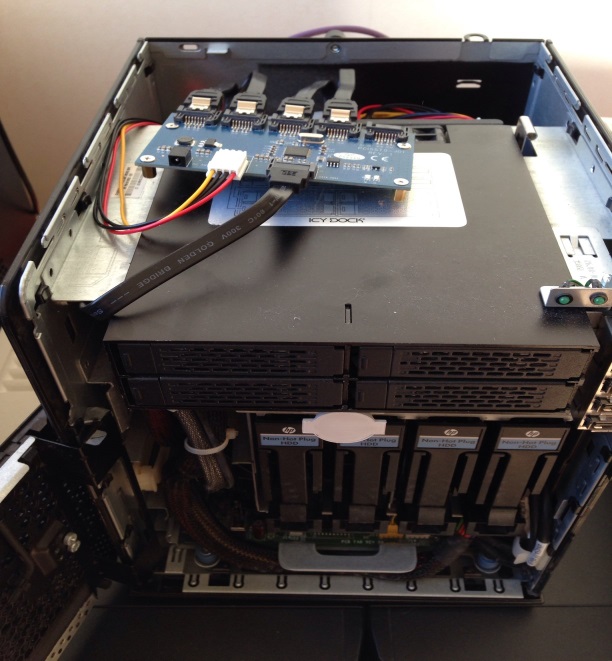
Vous l’aurez compris, c’est le port ODD interne que nous avons choisi d’utiliser pour rester dans l’esprit NAS compact.

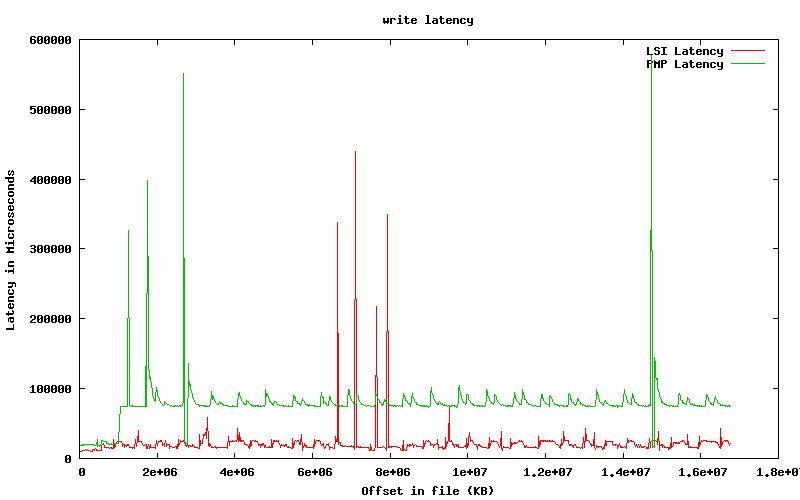
Pour avoir une idée de l’impact qu’une telle solution pouvait avoir sur les performances, nous l’avons comparée à une carte LSI 1068E. Après une séance d’iozone sur un zpool de 4 SSD en striping, nous avons fait chauffer le gnuplot :
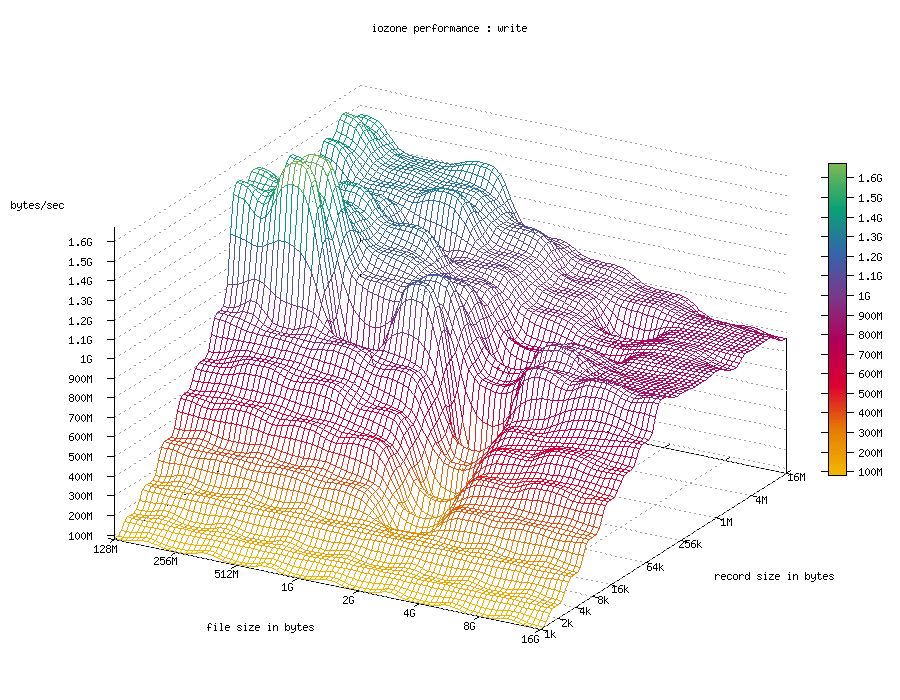
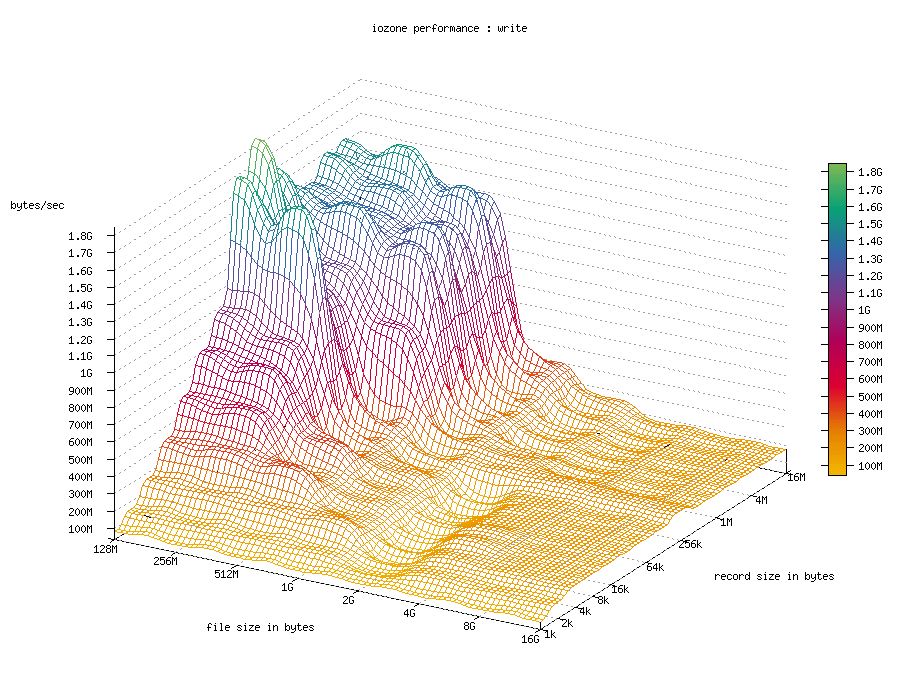
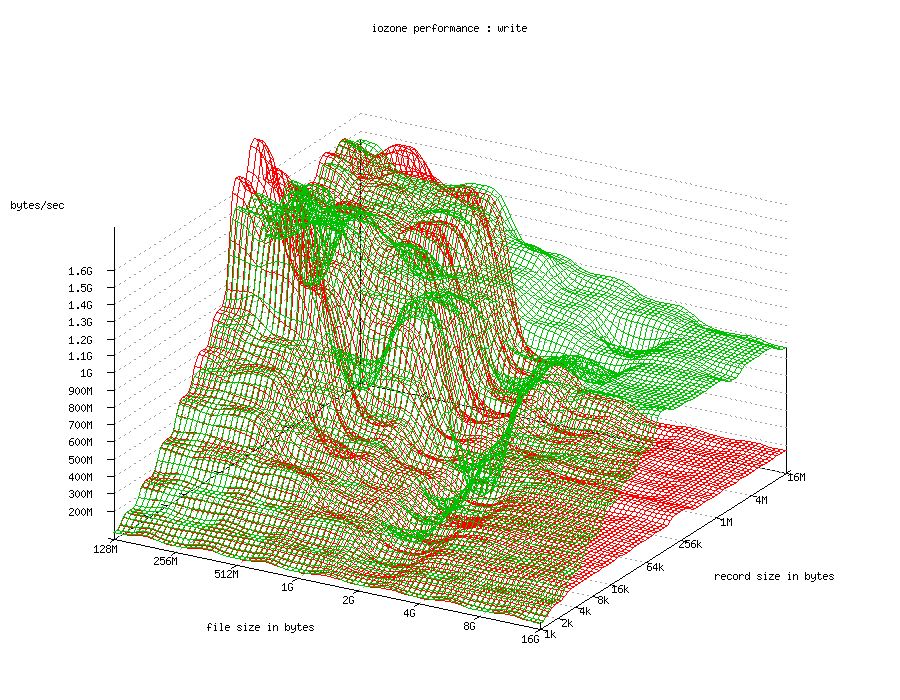
Si l’impact sur la latence est acceptable, celui sur les débits d’écriture est très important puisque l’on passe de ~800Mo/s à ~200Mo/s mais il fallait s’y attendre. On constate par contre que tant que les IO restent dans la fenêtre des TXG de ZFS, les débits sont identiques.

Au final, même si les performances sont moins bonnes qu’avec une carte contrôleur, elles sont malgré tout bien meilleures que ce qui pourra passer par un port GbE. De plus, FreeNAS ne supportant pas *encore* FC ou infiniband, une carte dual ou quad GbE  reste un bon début.
Tags: , , , , , ,

ESXCLI is the new VUM

Lors d’une tentative d’upgrade d’ESXi 5.1 vers 5.5 avec VUM, nous nous sommes heurté à un message d’erreur des plus vagues :

The upgrade contains conflicting VIBs. Remove the conflicting VIBs or use Image Builder to create a custom upgrade ISO image that contains the newer versions of the conflicting VIBs, and try to upgrade again.

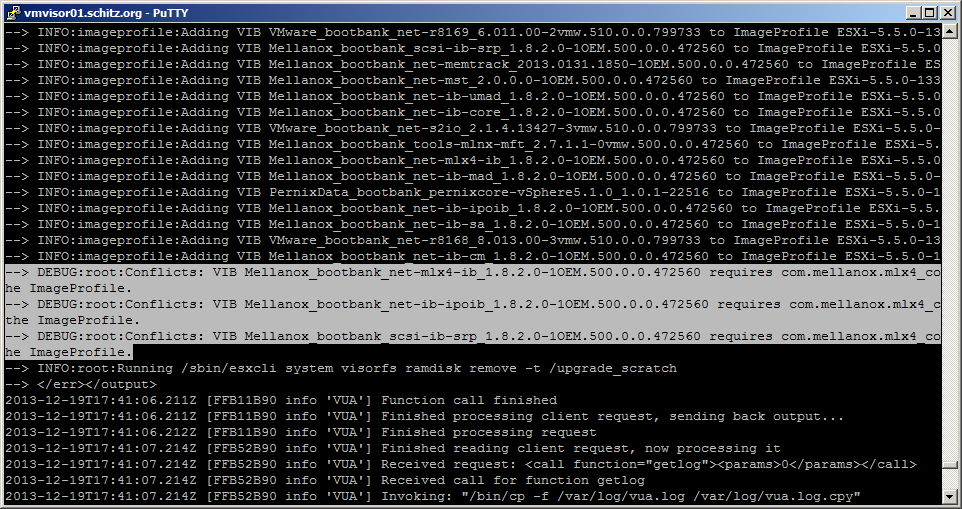
Il nous a fallu fouiller au fin fond des logs d’ESXi pour identifier les VIB en question :

Si vous lisez attentivement les release notes, vous savez déjà que depuis ESXi 5.1 il est possible d’upgrader avec la commande esxcli directement depuis le vib depot de VMware (William Lam a d’ailleurs écrit un post à ce sujet pour détailler le process) :

You can upgrade and apply patches to ESXi 5.0.x hosts by using the esxcli command-line utility for ESXi to upgrade to ESXi 5.1 from a download depot on vmware.com or from a downloaded ZIP file of a depot that is prepared by a VMware partner.

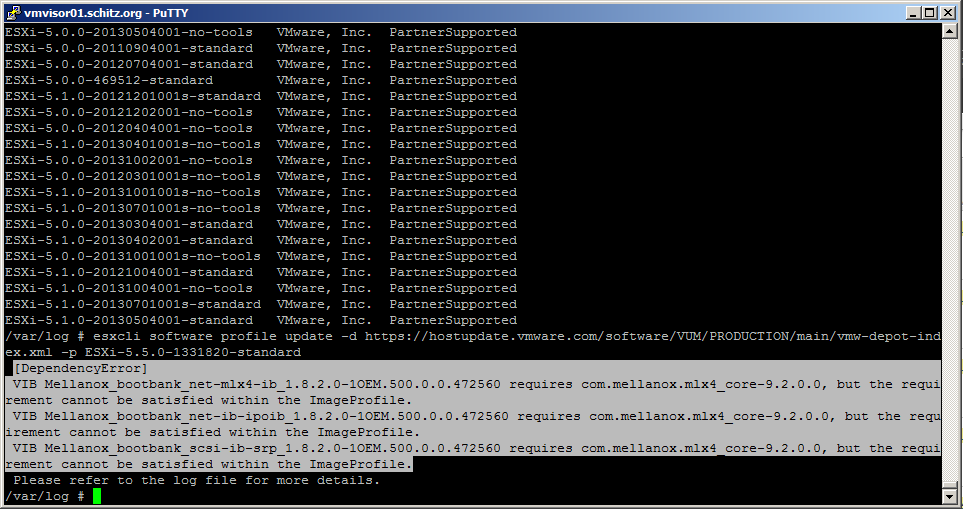
Nous avons donc tenté la même opération en ssh et l’erreur retournée par ESXCLI est nettement plus précise que celle de VUM :

Au passage, on attend toujours un plugin VUM digne de ce nom pour le webclient…

Tags: , , ,

#QuickDasAutoSlotSize Failover Capacity (Planning)

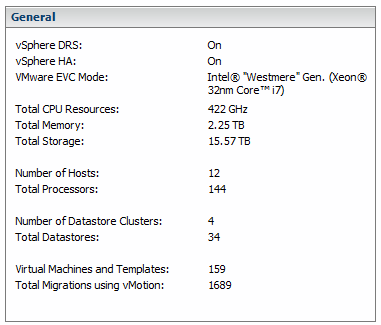
Depuis plusieurs mois maintenant, nous utilisons notre script HA AutoSlotSize sur un environnement composé de plusieurs gros cluster comme celui-ci :

Premier constat, le temps de compute des valeurs moyennes de cpu et ram est très important et c’est évidement proportionnel au nombre de nœuds. Pour optimiser ce script, nous nous somme rabattu sur les quickstats du resource pool “racine” du cluster (aka “resources”). Ces valeurs étant basé sur les 5 dernières minutes d’activité (et non sur les 24 dernières heures comme le script original), il faut l’exécuter au moment de la journée où l’activité du cluster est la plus importante pour avoir des valeurs vraiment représentatives du workload. Le gros avantage de ces valeurs est qu’il n’est pas nécessaire de faire une requête dans les statistiques, elles sont pré-computées et disponibles sous forme de propriétés, on passe donc d’une exécution pouvant aller jusqu’à plusieurs minutes à 2 secondes par cluster. Comme dirait Mozinor, “tu peux pas test”.

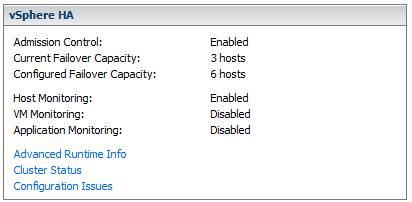
Deuxième constat, le mode “slot size” d’admition control ne tiens pas compte de l’overcommit. Duncan et Frank l’explique en détail dans leur bouquin mais voici un exemple encore plus parlant :

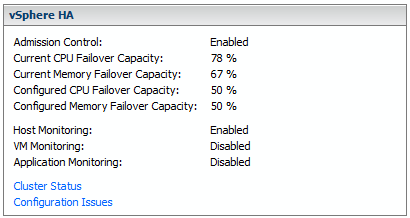
3 hosts sur 12 (25%) en mode “slot size” contre 67% en mode “resources”. Dans ce dernier mode, HA tiens compte de la consommation réelle du cluster pour déterminer ce qu’il reste.

With the resources failover policy in place, vSphere HA uses the following calculations to control virtual machine migration in the cluster
1. Calculate the total resource requirements for all powered-on virtual machines in the cluster.
[...]

Il est donc clair que sur des gros cluster avec de l’overcommit, le mode “slot size” est totalement inutilisable.

En attendant de déguster la dinde farcie aux marrons de tante Yolande, voici le oneliner powershell à deguster en amuse-bouche :

foreach ($cluster in (Get-View -ViewType ClusterComputeResource|?{$_.ConfigurationEx.DasConfig.Enabled})) {,($cluster|?{$_.host}|select @{n="mem";e={(($_|%{(Get-View $cluster.ResourcePool|?{$_.Parent -eq $cluster.Moref}).Summary.QuickStats.HostMemoryUsage/(Get-View -ViewType virtualmachine -SearchRoot $cluster.moref -Property Runtime.PowerState|?{$_.Runtime.PowerState -eq "poweredOn"}).count}))}}, @{n="cpu";e={(($_|%{((Get-View $cluster.ResourcePool|?{$_.Parent -eq $cluster.Moref}).Summary.QuickStats.OverallCpuUsage)/(Get-View -ViewType virtualmachine -SearchRoot $cluster.moref -Property Runtime.PowerState|?{$_.Runtime.PowerState -eq "poweredOn"}).count}))}}, @{n="vcpu";e={(Get-View -ViewType virtualmachine -SearchRoot $cluster.moref -Property Runtime.PowerState,Config.Hardware.NumCpu|?{$_.Runtime.PowerState -eq "poweredOn"}|Select @{n="vcpu";e={$_.Config.Hardware.NumCPU}}|Measure-Object -Average -Property vcpu).average}}|measure -average -property mem,cpu,vcpu|%{[math]::round($_.average,0)})|%{if (($_|measure -Sum).sum -ne ($cluster.ConfigurationEx.DasConfig.Option|?{$_.key -match "das.slotCpuInMhz|das.slotMemInMB"}|measure -Sum -Property value).sum -and ($_|measure -Sum).sum -gt "64") {$cluster.ReconfigureComputeResource((New-Object VMware.Vim.ClusterConfigSpecEx -property @{dasConfig=(New-Object VMware.Vim.ClusterDasConfigInfo -property @{option=@((New-Object VMware.Vim.OptionValue -property @{key="das.vmMemoryMinMB";value=$_[0].tostring()});(New-Object VMware.Vim.OptionValue -property @{key="das.vmCpuMinMHz";value=$_[1].tostring()});(New-Object VMware.Vim.OptionValue -property @{key="das.slotMemInMB";value=$_[0].tostring()});(New-Object VMware.Vim.OptionValue -property @{key="das.slotCpuInMhz";value=$_[1].tostring()}))})}),$true)}}}

Joyeux Noël à tous !

Tags: , , , , , ,

VMware HA datastore proxy

Pendant le setupage du premier super stretched cluster maison en production avec notre cher confrère vmdude.fr, ce dernier a émis une judicieuse remarque sur la possibilité que notre design rende impossible le fonctionnement de Datastore Heartbeat:

When the master host in a vSphere HA cluster can not communicate with a slave host over the management network, the master host uses datastore heartbeating to determine whether the slave host has failed, is in a network partition, or is network isolated.

Mais qu’en est il lorsque le master n’a pas accès au datastore en question ? C’est après une bonne séance de tests, en isolant volontairement un ESX du réseau de management, avec décorticage de logs que nous avons trouvé la réponse:

17:31:25.502Z [...] Marking slave host-145 as unreachable
17:31:25.502Z [...] [ClusterDatastore::RemoveMountHost] No longer proxying through host-145 for /vmfs/volumes/404021e9-b4550ea3
17:31:25.502Z [...] Releasing datastore /vmfs/volumes/404021e9-b4550ea3
17:31:25.502Z [...] [InventoryManagerImpl::NotifyDatastoreUnlockedLocally] Invoked for datastore (/vmfs/volumes/404021e9-b4550ea3).
[...]
[...]
17:31:26.513Z [...] [ClusterDatastore::CheckMasterDatastore] Acquiring remote datastore /vmfs/volumes/404021e9-b4550ea3
17:31:26.513Z [...] AcquireViaSlave: Selected slave host-240
17:31:26.513Z [...] AcquireViaSlave: Acquiring from slave host-240
[...]
[...]
17:31:26.614Z [...] [ClusterManagerImpl::ProcessAcquireDatastoreReply] path /vmfs/volumes/404021e9-b4550ea3
[...]
[...]
17:31:30.549Z [...] [ClusterSlave::UnreachableCheck] Waited 5 seconds for icmp ping reply for host host-145
17:31:30.549Z [...] [ClusterSlave::UnreachableCheck] Checking for Partition
[...]
[...]
17:32:08.803Z [...] [ClusterDatastore::ProcessReadHBReply] Failure for /vmfs/volumes/404021e9-b4550ea3 from slave host-240
17:32:08.803Z [...] [ClusterDatastore::UpdateSlaveHeartbeats] (NFS) host-145 @ host-145 is ALIVE

Notre interprétation est que l’ESX que nous avons volontairement isolé (host-145) avait été désigné “proxy” car il avait accès à des datastores que le master ne pouvait pas atteindre. Lorsqu’il n’a plus été joignable, un autre slave (host-240) à été choisi pour remonter les informations de datastore heartbeating au master pouvant ainsi déterminer si le slave (host-145) était mort ou isolé . Grace à Duncan Epping, nous en avons eu la confirmation :

The proxying is designed for a situation where the master cannot see a specific datastore, but slaves can. In that case the proxy service is used by the master to allow certain actions to take place.

Conclusion, même dans un cluster où la moitié des ESX ne sont pas connectés aux datastores de l’autre moitié, FDM est capable d’utiliser un (ou plusieurs ?) slave en tant que proxy pour assurer les fonctions du master.

Tags: , , ,

Stretched Cluster for Dummies

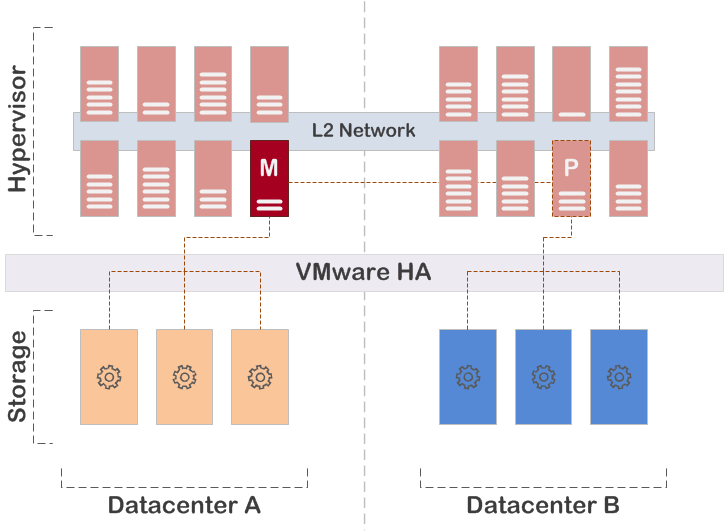
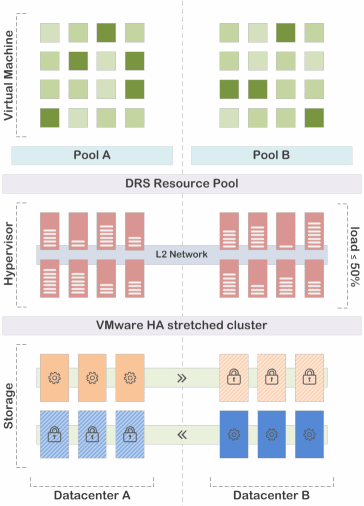
Pour ceux qui auraient besoin d’expliquer à leur DSI le design que nous avons détaillé dans notre précédent post, voici le fichier powerpoint (avec les commentaires) qui vous sauvera.

Vous avez probablement remarqué la ressemblance frappante avec les schémas de Frank Denneman et c’est tout à fait voulu. Frank a en effet démontré depuis longtemps l’intérêt de ces schémas ultra épurés avec le moins de texte possible et des couleurs très soft. D’ailleurs, c’est nettement plus dur à faire qu’il n’y parait…

Nous avons également produit une version pdf sans commentaires.

Tags: , , ,